DESIGN OF A SOFTWARE COMPONENT FOR MANAGING DATA CONSISTENCY POLICIES IN A GEO-DISTRIBUTED BUSINESS INFORMATION SYSTEM
Введение
Геораспределенная бизнес-информационная система характеризуется размещением данных и вычислительных компонентов в нескольких территориально удаленных узлах. Такая архитектура позволяет снижать задержки доступа, повышать отказоустойчивость и обеспечивать масштабирование, однако усложняет поддержание согласованного состояния данных из-за сетевых задержек, лага репликации, частичных отказов и конкурирующих изменений.
Для обеспечения согласованности данных используются разные подходы: настраиваемые уровни чтения и записи, транзакционные механизмы распределенных СУБД, ограничения устарелости данных и контекстно зависимый выбор уровня консистентности. При этом единая стратегия консистентности не может быть одинаково эффективной для всех данных и операций: строгая согласованность повышает стоимость межрегиональной координации, а ослабленные модели могут приводить к устаревшим чтениям и нарушению бизнес-инвариантов.
В связи с этим возникает необходимость формализованного управления правилами выбора консистентности с учетом домена данных, типа операции, допустимой устарелости информации и возможностей используемого хранилища. Одним из способов решения данной задачи является проектирование программного компонента управления политиками консистентности данных.
Цель исследования заключается в разработке проектных решений для программного компонента управления политиками консистентности данных в геораспределенной бизнес-информационной системе.
Материалы и методы исследования
Исследование опирается на научные публикации и технические работы, посвященные управлению консистентностью данных в распределенных и геораспределенных информационных системах [1-3]. При анализе также учитывались работы, раскрывающие настраиваемую причинную консистентность и влияние уровня согласованности на задержку выполнения операций [4; 5]. Отдельно были рассмотрены подходы, связанные с реплицируемыми типами данных и проверкой их согласованности [6; 7].
В рамках анализа были рассмотрены четыре группы подходов. Первая группа связана с использованием настраиваемых уровней консистентности при выполнении операций чтения и записи. Данный подход применяется в распределенных хранилищах и позволяет выбирать компромисс между актуальностью данных, доступностью и задержкой выполнения операции [8-10]. Вторая группа подходов связана с распределенными SQL-СУБД, где согласованность обеспечивается за счет транзакционных механизмов, уровней изоляции и координации между узлами [11-13]. Третья группа подходов основана на выборе уровня консистентности с учетом контекста операции: типа данных, характеристик запроса, допустимой устарелости и состояния системы [4; 5]. При этом влияние выбранного уровня консистентности на производительность особенно важно для NoSQL-хранилищ, где изменение гарантий согласованности может отражаться на задержке и скорости доступа к данным [14]. Четвертая группа подходов связана с вынесением правил принятия решений из прикладного кода в отдельный управляющий слой [15].
Сравнение рассмотренных подходов приведено в таблице 1.
В качестве метода исследования был использован сравнительный анализ. Рассмотренные подходы сопоставлялись по следующим критериям: уровень применения политики, гранулярность настройки, зависимость от конкретной базы данных, поддержка геораспределенности, влияние на производительность, надежность, наблюдаемость и сложность внедрения. Наиболее значимыми для дальнейшего проектирования были определены гранулярность настройки, зависимость от конкретной базы данных, поддержка геораспределенности и влияние выбранного уровня консистентности на задержку выполнения операций. Сопоставление подходов также позволило выделить основные ограничения: отсутствие универсального механизма консистентности для всех сценариев, зависимость реализации от возможностей конкретного хранилища, рост задержек при усилении гарантий согласованности и необходимость формального описания контекста операции.
Таблица 1
Сравнение подходов к управлению консистентностью данных
|
Подход |
Основная идея |
Ограничения |
|
Настраиваемые уровни консистентности |
Выбор уровня согласованности для операций чтения и записи |
Зависимость от механизмов конкретного хранилища |
|
Транзакционная консистентность |
Обеспечение согласованности через транзакции, уровни изоляции и координацию узлов |
Рост задержек и необходимость обработки конфликтов |
|
Контекстно зависимое управление консистентностью |
Выбор уровня консистентности с учетом параметров операции и состояния системы |
Необходимость формального описания контекста и правил выбора |
|
Централизованное описание правил |
Вынесение правил принятия решений из прикладной логики в отдельный управляющий слой |
Не является самостоятельным механизмом обеспечения консистентности |
Примечание: составлено авторами на основе источников [4; 5; 8–15].
Эти выводы использованы далее при формировании групп требований и разработке программной архитектуры компонента.
Результаты исследования и их обсуждение
В результате анализа существующих подходов было установлено, что управление консистентностью данных в геораспределенной информационной системе не может быть сведено к единому техническому механизму. Настраиваемые уровни консистентности позволяют задавать разные гарантии для операций чтения и записи, однако зависят от возможностей конкретного хранилища [8; 10]. Транзакционные механизмы распределенных SQL-СУБД обеспечивают строгую согласованность, но требуют межузловой координации и могут увеличивать задержку выполнения операций [11-13]. Подходы с настраиваемыми гарантиями согласованности позволяют выбирать модель консистентности с учетом требований операции, но требуют формального описания параметров такого выбора [4; 5]. Policy-based подходы позволяют вынести правила принятия решений из прикладного кода, но сами по себе не обеспечивают консистентность данных [15].
На основании проведенного анализа были сформированы группы требований к программному компоненту управления политиками консистентности данных (табл. 2). Требования отражают необходимость централизованного описания политик, выбора применимой политики по контексту операции и сопоставления логического требования к согласованности с доступным техническим механизмом реализации.
Для уточнения логики применения компонента была построена процессная модель выбора политики консистентности при выполнении операции с данными. Данный процесс отражает основной сценарий работы компонента и показывает, какие действия должны быть поддержаны его программной архитектурой.
Процесс начинается с формирования бизнес-сервисом контекста операции. В состав контекста могут входить домен данных, тип операции, регион выполнения, критичность операции и требования к свежести данных. На основании полученного контекста компонент управления политиками выполняет поиск применимых политик и проверяет условия их применения. Если подходящая политика не найдена, компонент формирует отказ в выполнении операции. Если политика найдена, она сопоставляется с доступным механизмом технической реализации, после чего операция передается в слой доступа к данным с учетом выбранных параметров. Представленная процессная модель показывает, что компонент должен поддерживать прием контекста операции, выбор применимой политики, проверку возможности ее реализации и передачу параметров выполнения в слой доступа к данным. Эти действия были использованы как основание для определения состава модулей программной архитектуры.
С учетом сформированных требований и процессной модели была разработана программная архитектура компонента управления политиками консистентности. Компонент рассматривается как отдельный управляющий слой, расположенный между бизнес-сервисами и слоем доступа к данным. Его назначение состоит в отделении правил выбора политики консистентности от прикладной логики и конкретных механизмов хранилищ данных.
Таблица 2
Группы требований к программному компоненту
|
Группа требований |
Содержание |
|
Управление политиками |
Создание, просмотр, изменение, удаление и проверка политик консистентности данных |
|
Описание области применения |
Задание домена данных, типа операции, региона и иных параметров контекста |
|
Описание требований к консистентности |
Задание уровня согласованности, допустимой устарелости данных, требований к порядку операций и видимости изменений |
|
Выбор политики |
Получение контекста операции и поиск применимой политики с учетом условий ее применения |
|
Сопоставление с техническим механизмом |
Определение способа реализации логической политики средствами выбранного хранилища данных |
|
Обработка исключительных ситуаций |
Формирование отказа при отсутствии подходящей политики или неподдерживаемом механизме реализации |
|
Нефункциональные требования |
Минимальная дополнительная задержка, доступность, расширяемость, наблюдаемость и независимость логики выбора политики от конкретной базы данных |
Примечание: составлено авторами на основе полученных данных в ходе исследования.
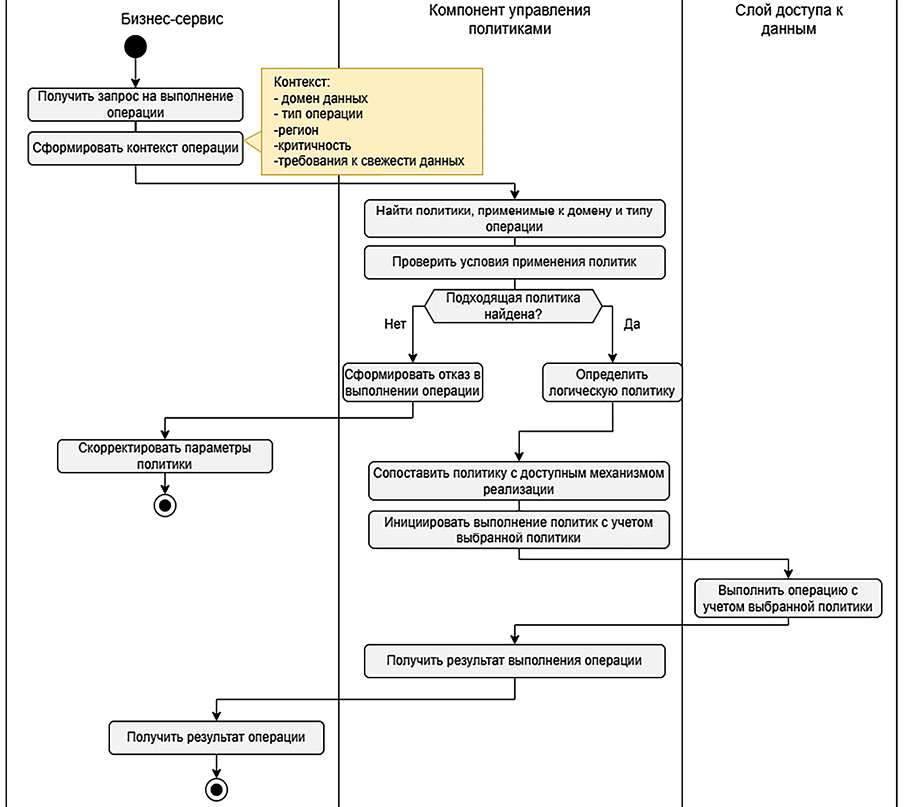
Рис. 1. Процесс выбора политики консистентности при выполнении операции Источник: составлено авторами по результатам данного исследования
Программная архитектура компонента представлена на рис. 2.
В архитектуре выделены два основных контура. Первый контур связан с управлением политиками и используется администратором для создания и изменения правил консистентности. В него входят API управления политиками, модуль проверки политик и хранилище политик. API управления политиками принимает описание политики, модуль проверки контролирует полноту, корректность и непротиворечивость заданных параметров, после чего корректная политика сохраняется в хранилище.
Второй контур связан с применением политики при выполнении операции с данными. Бизнес-сервис передает в компонент контекст операции, включающий домен данных, тип операции, регион выполнения, критичность операции и требования к свежести данных. API применения политики передает полученный контекст в модуль выбора политики. Данный модуль выполняет поиск подходящего правила в хранилище политик и проверяет условия его применения. Если политика не найдена, компонент формирует отказ в выполнении операции. Если политика найдена, она передается в модуль сопоставления с механизмом реализации.
Модуль сопоставления с механизмом реализации определяет, каким техническим способом может быть применена выбранная логическая политика. Для этого используется конфигурация механизмов реализации, содержащая сведения о поддерживаемых способах обеспечения консистентности в используемой технологической среде. К таким способам могут относиться уровни согласованности запросов, ограничения устарелости данных и кворумные механизмы [8-10].
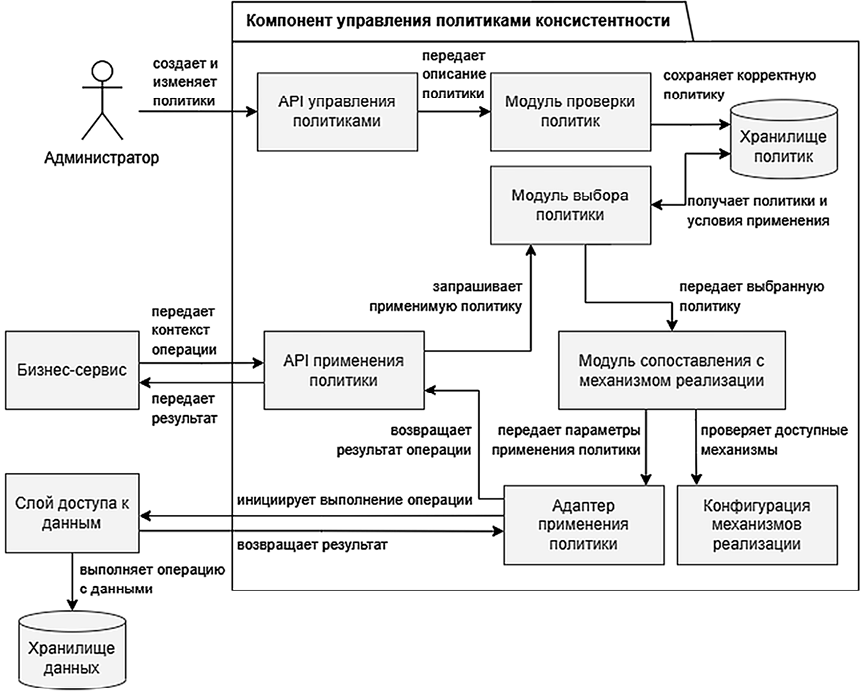
Рис. 2. Программная архитектура компонента управления политиками консистентности данных Источник: составлено авторами по результатам данного исследования
Для распределенных SQL-СУБД также могут учитываться транзакционные режимы, уровни изоляции и механизмы координации между узлами [11-13]. При выборе механизма необходимо учитывать его влияние на задержку выполнения операций и производительность доступа к данным [14].
Предложенная архитектура позволяет разделить три уровня ответственности. На прикладном уровне бизнес-сервис формирует контекст операции, но не содержит правил выбора консистентности. На управляющем уровне компонент выбирает применимую политику и определяет способ ее реализации. На технологическом уровне слой доступа к данным и хранилище выполняют операцию с учетом выбранных параметров. Такое разделение снижает зависимость прикладных сервисов от особенностей конкретной СУБД и упрощает изменение правил консистентности при изменении требований к данным.
Таким образом, основным результатом исследования является программная архитектура компонента, обеспечивающего централизованное управление политиками консистентности данных. Компонент не заменяет механизмы распределенных СУБД, а связывает требования к данным и операциям с доступными техническими средствами их реализации. Полученное проектное решение может быть использовано как основа для разработки прототипа и последующей проверки корректности выбора политик в геораспределенной бизнес-информационной системе.
Заключение
Предложенный программный компонент может быть использован в геораспределенных бизнес-информационных системах, где для разных доменов данных и операций требуются различные гарантии консистентности. Его применение позволяет централизовать правила выбора политики, уменьшить зависимость прикладных сервисов от особенностей конкретных хранилищ данных и повысить прозрачность управления требованиями к согласованности. Это особенно важно для систем, в которых необходимо одновременно учитывать актуальность данных, доступность, задержки выполнения операций и ограничения межрегиональной координации.
Практическая значимость разработанной архитектуры заключается в том, что она создает основу для последующей реализации прототипа и проверки применимости компонента в реальной информационной системе. Ожидаемый эффект от использования такого решения связан с упрощением сопровождения политик консистентности, снижением риска неявного применения разных стратегий в прикладном коде и повышением управляемости работы с данными в геораспределенной среде.
Conflict of Interest
Funding
Bibliographic Reference
URL: https://science-engineering.ru/en/article/view?id=1539 (accessed: 17/10/2026).
DOI: https://doi.org/10.17513/srts.1539